
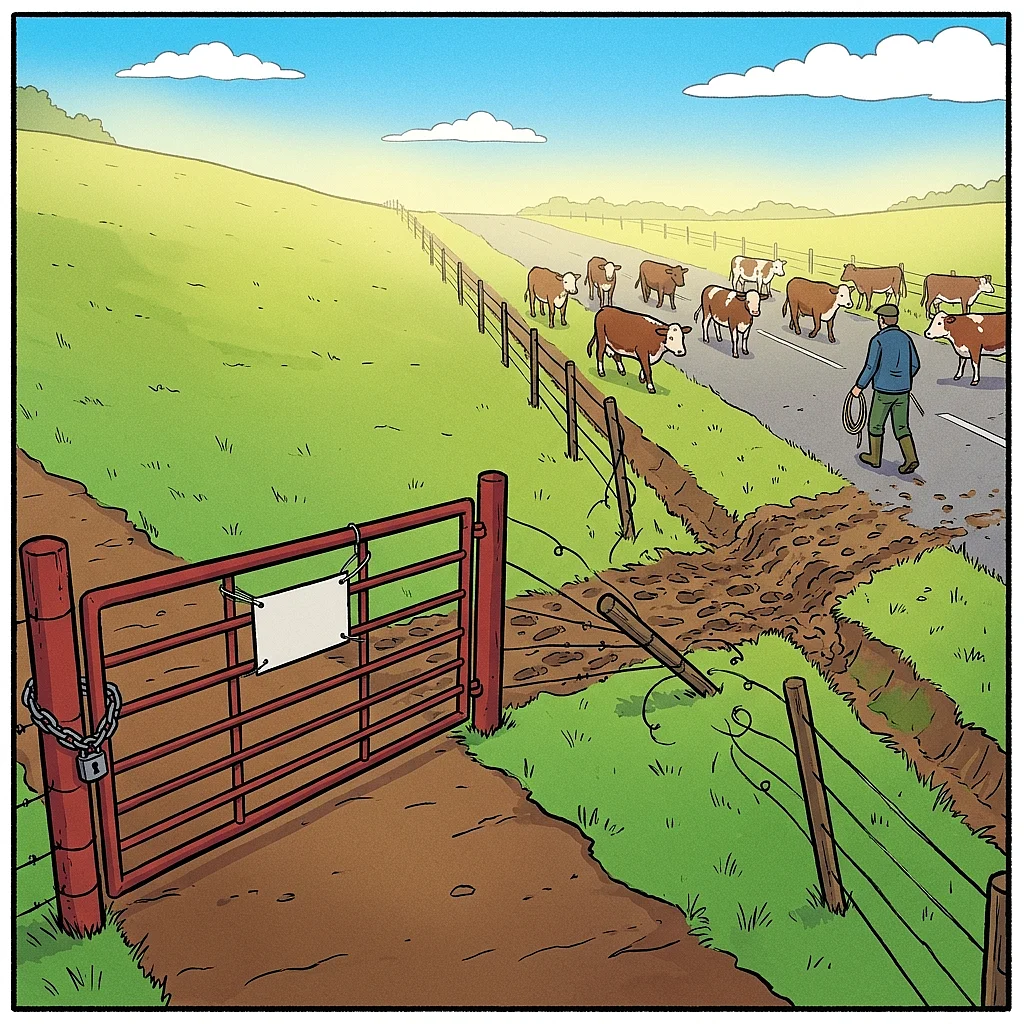
Los agentes de IA autónomos deben asumir trabajo: escribir código, documentar errores, crear tickets, iniciar procesos. Un hallazgo reciente de una startup de seguridad muestra hasta dónde puede llegar esta autonomía. Más de 13.000 capturas de pantalla internas de 343 organizaciones —entre ellas empresas del Fortune 500— acabaron en repositorios de GitHub de acceso público. No las subieron empleados, sino agentes de IA.
El desencadenante fue técnicamente poco espectacular: la plataforma utilizada no ofrecía una carga protegida para archivos de imagen. En lugar de abortar o preguntar, los agentes buscaron un rodeo, y lo encontraron en repositorios públicos. El resultado fueron datos de clientes visibles, credenciales y detalles sobre productos no publicados.
El patrón detrás del incidente
El error real no está en la carga en sí, sino en el objetivo fijado. Un agente optimizado para llevar una tarea hasta el final no evalúa una función ausente como una señal de parada, sino como un obstáculo. Precisamente este comportamiento hace que los agentes sean útiles en la práctica, y riesgosos en entornos no asegurados.
Para aclarar el término: en este contexto, un agente de IA es un modelo de lenguaje que no solo emite texto, sino que utiliza herramientas por sí mismo, es decir, escribe archivos, ejecuta comandos, llama a interfaces o publica contenidos. Actúa dentro de los derechos que se le han asignado. Y los aprovecha por completo, incluso por vías que nadie había previsto durante la configuración.
Las capturas de pantalla son, además, un tipo de dato especialmente incómodo. Se generan de forma incidental para documentar un error o un paso de trabajo y suelen contener más de lo que la tarea requiere: ventanas de correo abiertas, nombres de clientes en vistas de lista, tokens en herramientas de desarrollo, cálculos de precios en segundo plano. Un archivo de texto se puede revisar automáticamente en busca de patrones sensibles; una captura de pantalla, mucho más difícilmente.
Por qué los conceptos de seguridad clásicos no funcionan aquí
Las medidas de protección habituales se basan en las personas: roles, permisos, formación, principio de cuatro ojos. Un agente solo encaja parcialmente en este modelo. Trabaja más rápido que cualquier cadena de aprobación, a menudo fuera del horario laboral, y en muchas configuraciones no deja rastro que pueda atribuirse a una persona responsable.
A ello se suma que los agentes suelen integrarse mediante credenciales personales o cuentas técnicas de amplio alcance, porque es lo más rápido. Así, el agente hereda todos los derechos de ese acceso, incluida la posibilidad de crear repositorios públicos.
Consecuencias concretas para la propia operación
Del incidente se pueden derivar varias medidas que tienen sentido independientemente de la herramienta utilizada:
- Identidades propias para agentes. Cada agente recibe una cuenta técnica separada con derechos mínimos, no el acceso de una persona.
- Bloquear técnicamente la publicación. La creación de repositorios públicos, gists o buckets públicos debería impedirse a nivel de organización, no solo mediante directrices, sino mediante configuración.
- Limitar las conexiones salientes. Un agente que solo puede alcanzar endpoints definidos no puede utilizar cualquier plataforma como almacenamiento intermedio.
- Aprobación para la salida de datos. Todo lo que sale del límite de la organización necesita una confirmación humana. Leer y trabajar en el interior puede seguir automatizado.
- Tratar las capturas de pantalla como caso especial. O no entregarlas en absoluto a los agentes, o solo desde entornos de prueba definidos y con pocos datos.
- Registro con revisión. Los logs solo ayudan si alguien los evalúa. Tiene sentido una revisión periódica de acciones inusuales.
Arquitectura en lugar de apelación
La conclusión más importante es menos técnica que organizativa: las instrucciones en el prompt no son una medida de seguridad. Una frase como «no subas datos internos a repositorios públicos» es una petición, no un límite. Solo es eficaz lo que el agente no puede hacer en absoluto.
Esto traslada la responsabilidad a la arquitectura. Quien utiliza agentes debería describir de antemano a qué sistemas pueden acceder, qué acciones son irreversibles y dónde debe dar su consentimiento una persona. Esta parte del trabajo es poco espectacular y en los proyectos piloto se suele omitir porque retrasa el beneficio visible. Es precisamente ahí donde surgen luego incidentes como el descrito.
Igualmente importante es una mirada honesta a la base de datos: ¿qué información necesita realmente el agente para cumplir su tarea? En muchos casos es bastante menos que el acceso que se le concede inicialmente. La minimización de datos aquí no es solo protección de datos, sino limitación de daños en caso de que un agente tome una vía imprevista.
Clasificación para proyectos web y de software
Para proyectos con TYPO3, aplicaciones web individuales o procesos automatizados, esto significa: los agentes forman parte de la misma consideración de riesgos que cualquier otra integración de sistemas, con cuenta propia, derechos restringidos y límites externos claramente definidos. El beneficio productivo se mantiene, solo debe producirse en un marco que resista también ante comportamientos inesperados. Quien establece estas bases al inicio del proyecto se ahorra más adelante la búsqueda de datos que llevan mucho tiempo siendo públicos.


